머신러닝 모델을 학습한 뒤 실제 서비스에서 사용하려면 데이터 준비, 배포, 모니터링이 함께 필요합니다. 이번 글에서는 『머신러닝 플랫폼 엔지니어링』 책의 1~2챕터에서 다룬 머신러닝 수명주기와 MLOps를 정리하고, 각 단계를 지원하는 플랫폼의 역할을 살펴봅니다.
1. 모델을 만드는 일과 운영하는 일
스팸 분류 모델을 만들었다고 가정하겠습니다. 과거 메일로 학습하고 새 메일도 잘 분류하는지 확인했다면, 모델 개발의 한 단계를 마친 것입니다.
사용자가 이 모델을 이용하려면 메일을 입력받는 프로그램, 모델을 실행할 서버, 결과를 반환하는 기능이 필요합니다. 운영 중에는 오류가 발생하는지, 응답이 느려지는지, 정상 메일을 스팸으로 잘못 분류하는지도 확인해야 합니다.
새로운 유형의 스팸이 나타나면 기존 모델의 성능이 떨어질 수 있습니다. 이때는 데이터를 추가로 모으고 모델을 다시 평가하거나 학습해야 합니다. 첫 배포 이후에도 데이터와 모델을 관리하는 작업이 계속됩니다.
2. 실험 단계: 모델 훈련·평가·검증의 반복
머신러닝 프로젝트는 반복적인 성격을 띱니다. 한 번 데이터를 준비하고 모델을 훈련하는 것으로 끝나는 것이 아니라, 훈련·평가·검증 과정에서 확인한 문제를 바탕으로 데이터를 보완하거나 모델을 다시 훈련합니다.
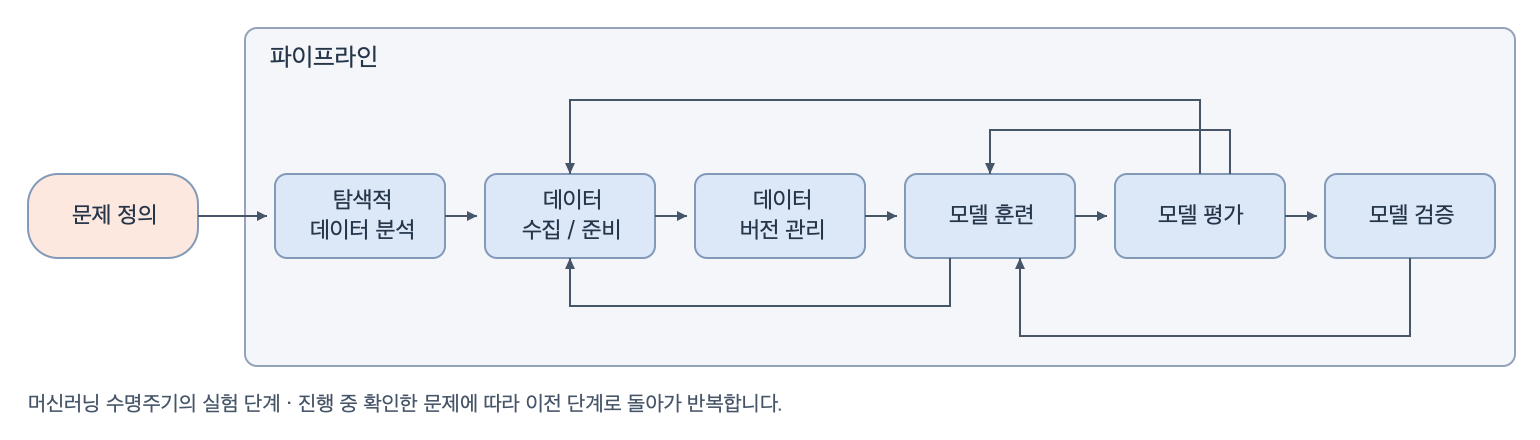
문제 정의
머신러닝 프로젝트를 시작할 때는 먼저 “이 문제를 해결하는 데 과연 머신러닝을 사용해야 하는가?”를 질문해야 합니다.
데이터를 수집하고 모델을 훈련하기 전에, 사람이 정한 간단한 규칙으로도 충분히 해결할 수 있는지 확인합니다. 경험이나 관찰을 바탕으로 만든 실용적인 판단 규칙을 휴리스틱(Heuristic)이라고 합니다.
예를 들어 상품의 재고가 부족해지기 전에 담당자에게 알림을 보내려 한다고 가정하겠습니다. 처음부터 재고 예측 모델을 만드는 대신, “재고가 10개 미만이면 알림을 보낸다”는 간단한 규칙으로 시작할 수 있습니다.
이 규칙만으로 재고 부족에 충분히 대응할 수 있다면 머신러닝이 필요하지 않을 수 있습니다. 여기서 10개는 설명을 위한 예시이며, 실제 기준은 상품과 운영 상황에 맞게 정해야 합니다.
반면 상품마다 판매 속도와 입고에 걸리는 시간이 달라 고정된 기준으로 대응하기 어렵다면, 향후 수요를 예측하는 머신러닝 모델을 검토할 수 있습니다. 이때도 필요한 데이터가 있는지, 모델을 운영할 비용에 비해 개선 효과가 충분한지 함께 판단합니다.
간단한 규칙으로 만든 결과는 이후 모델의 효과를 비교하는 기준으로도 사용할 수 있습니다. 복잡한 모델을 만들었다는 사실보다 기존 방식에 비해 문제를 얼마나 더 잘 해결하는지가 중요합니다.
머신러닝을 사용하기로 결정했다면, 모델이 풀어야 할 문제를 명확히 정의해야 합니다. 무엇을 입력받아 어떤 결과를 예측할지, 그 결과를 서비스에서 어떻게 사용할지 구체적으로 정합니다.
이후 단계는 신분증 이미지에서 ID 번호를 추출하는 OCR 프로젝트에 대입해 살펴보겠습니다. OCR(Optical Character Recognition)은 이미지에 있는 글자를 텍스트로 읽는 기술입니다. 이 프로젝트의 문제는 “신분증 이미지를 입력받아 ID 번호를 추출한다”로 정의할 수 있습니다. 추출한 번호를 업무에 어떻게 사용할지는 서비스에서 정할 동작입니다.
이후에는 성공 기준도 정해야 합니다. ID 번호를 얼마나 정확하게 추출해야 하는지, 번호를 잘못 읽거나 추출하지 못했을 때 어떻게 처리할지 등을 정합니다. 필요한 데이터와 운영 제약을 함께 정해야 이후 평가와 검증의 기준을 세울 수 있습니다.
탐색적 데이터 분석
탐색적 데이터 분석(Exploratory Data Analysis, EDA)은 데이터를 살펴보며 특징과 관계를 파악하고, 문제를 해결할 단서를 찾는 과정입니다. OCR 프로젝트라면 신분증 이미지의 해상도와 기울기, 글자의 선명도, ID 번호 영역의 위치 등을 살펴볼 수 있습니다.
EDA는 프로젝트 초기에 한 번 수행하고 끝내는 작업이 아니라 반복적인 프로세스입니다. 머신러닝 루프를 진행하면서 데이터셋에 대한 새로운 인사이트를 얻고, 실험이 실패할 때마다 기존 가정을 다시 검토합니다.
예를 들어 OCR 모델의 성능이 기대에 미치지 못했다면, “이미지 해상도는 충분하다”거나 “훈련 데이터가 실제 입력을 잘 대표한다”는 가정이 맞는지 데이터를 다시 살펴봅니다. 분석 결과에 따라 데이터를 보완하거나 처리 방법과 실험 방향을 조정하고, 다음 실험에서 다시 확인합니다.
그림에서는 EDA를 앞부분에 표시했지만, 실제로는 훈련·평가·검증 결과를 바탕으로 반복해서 수행합니다. 기존 데이터나 표본으로 분석을 시작할 수 있으며, 추가로 수집한 데이터에서도 새로운 특징을 확인할 수 있습니다.
데이터 수집 및 준비
모델이 풀어야 할 문제를 정의했다면, 훈련과 평가에 필요한 데이터를 어디서 확보할지 정해야 합니다. 신분증에서 ID 번호를 추출하는 OCR 프로젝트에서는 신분증 이미지가 필요합니다. 실제 데이터를 구하기 어렵다면 합성 데이터(Synthetic Data) 생성도 고려할 수 있습니다.
데이터를 확보한 다음에는 애노테이션(Annotation)을 통해 레이블(Label)을 붙입니다. 애노테이션은 데이터에 필요한 정답 정보를 표시하는 작업이고, 레이블은 그 결과로 남는 정답 정보라고 이해하면 됩니다.
책의 OCR 예시에서는 애노테이터가 ID 번호 주변에 경계 상자(Bounding Box)를 그리고, 그 안에 적힌 ID 번호를 직접 입력합니다. 모델이 어디를 읽어야 하는지와 어떤 글자로 읽어야 하는지를 표시하는 것입니다.
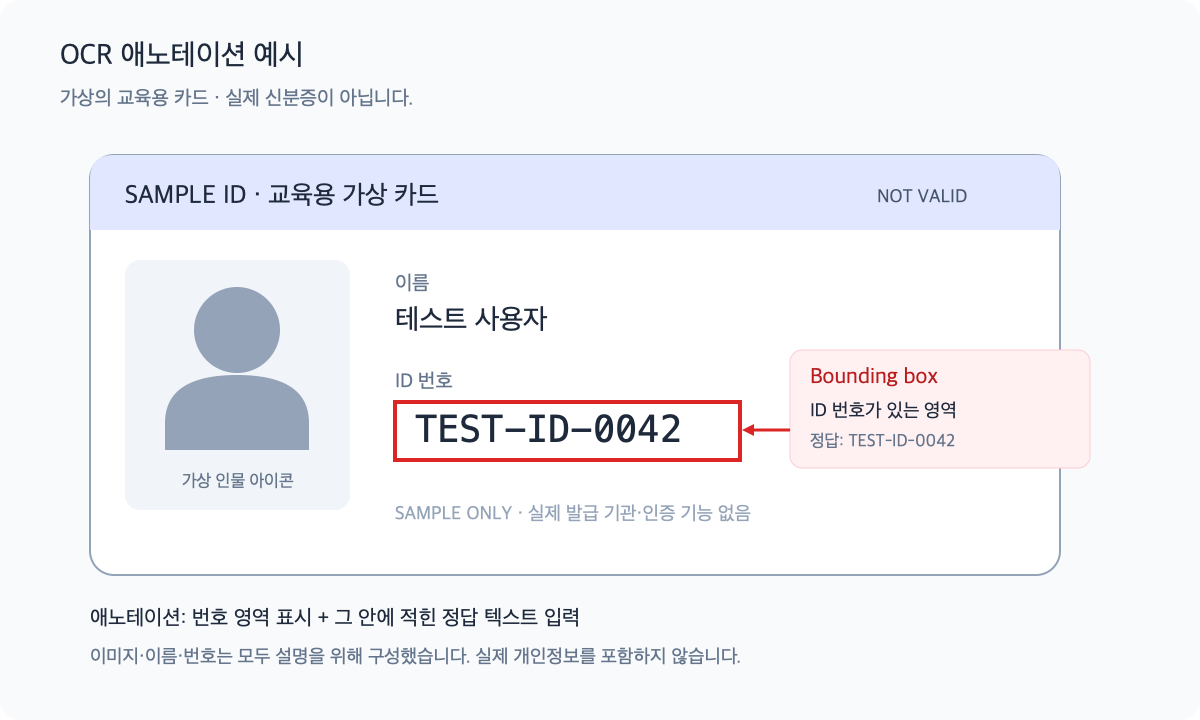
위 그림은 설명을 위해 만든 가상의 카드입니다. 빨간 상자가 ID 번호 영역이고, `TEST-ID-0042`가 해당 영역의 정답 텍스트입니다.
레이블이 준비되면 데이터를 훈련·검증·테스트 데이터셋으로 나눕니다. 모델을 학습시키는 데이터와, 학습 과정에서 모델을 확인하고 최종 성능을 평가하는 데이터를 구분하는 것입니다.
데이터를 수집하고 가공할 때는 데이터 리니지(Data Lineage)도 함께 기록해야 합니다. 데이터 리니지는 데이터가 어디에서 왔고, 어떤 과정을 거쳐 현재의 데이터셋이 되었는지 추적할 수 있게 하는 정보입니다.
OCR 프로젝트라면 이미지를 언제, 어디서, 어떤 목적으로 확보했는지와 함께, 원본 이미지에서 ID 번호 영역을 잘라내고 정답을 입력하거나 수정한 과정을 연결해 기록합니다. 원본뿐 아니라 중간 결과, 증강한 이미지와 애노테이션된 데이터 사이의 관계도 포함합니다.
예를 들어 정답 번호가 잘못 입력된 것을 발견했다면, 리니지를 통해 그 데이터가 어떤 원본에서 만들어졌고 어떤 가공 데이터셋에 포함되었는지 확인할 수 있습니다. 이를 바탕으로 수정해야 할 범위를 찾고 관련 데이터셋을 다시 생성하기 쉬워집니다.
데이터 버전 관리가 “어떤 상태의 데이터를 사용했는가”를 구분한다면, 데이터 리니지는 “그 데이터가 어디서 왔고 어떻게 만들어졌는가”를 설명합니다. 두 정보를 함께 관리해야 실험 결과의 원인을 추적하고 데이터를 수정할 때의 영향을 파악할 수 있습니다. 기록이 없다면 같은 데이터를 다시 만들기 위해 수집·가공 과정을 처음부터 확인해야 할 수 있습니다.
데이터 버전 관리
머신러닝 프로젝트는 데이터와 코드로 구성됩니다. 코드를 변경하면 소프트웨어의 동작이 달라지는 것처럼, 데이터를 변경해도 모델의 동작이 달라질 수 있습니다.
데이터 버전 관리의 핵심 목적은 재현성을 확보하는 것입니다. 어떤 실험에 어떤 데이터를 사용했는지 정확히 식별하고, 필요할 때 동일한 상태의 데이터를 다시 사용할 수 있어야 합니다.
책은 동일한 데이터와 코드가 주어졌을 때 모델이 기대한 대로 동작한다는 것을 확신할 수 있어야 한다고 강조합니다. 이전 결과를 다시 확인하려는데 당시 사용한 데이터를 알 수 없거나 이미 덮어썼다면, 같은 조건으로 실험을 재현하기 어렵습니다.
예를 들어 OCR 이미지가 추가되거나 잘못 입력한 정답 번호를 수정했다면, 이전 실험과 다른 데이터로 훈련하게 됩니다. 이 변경을 별도 버전으로 기록하고 코드·실험 이력과 연결하면, 수정 전후의 결과를 비교하거나 이전 데이터로 돌아가 확인할 수 있습니다.
여기서 재현성은 데이터 버전 관리만으로 모든 실행 결과가 자동으로 100% 같아진다는 뜻은 아닙니다. 훈련 설정과 실행 환경 등도 함께 관리해야 합니다. 데이터 버전 관리는 그중 동일한 데이터를 다시 확보할 수 있게 하는 기반입니다.
코드는 Git 등으로 관리할 수 있지만, 데이터는 이미지·CSV·데이터 프레임 등 형태가 다양해 코드와 같은 방식으로 관리하기 어렵습니다. 데이터의 저장 방식과 변경 과정을 고려해 버전을 관리해야 합니다.
데이터 수집·준비와 버전 관리는 역할이 다르지만, 실제로는 연결해서 수행합니다. OCR 프로젝트라면 이미지를 수집하고 애노테이션한 뒤 데이터셋 v1을 기록합니다. 모델을 평가한 결과 부족한 이미지를 추가하거나 정답을 수정했다면, 데이터셋 v2로 기록하고 다시 훈련·평가합니다. 버전 관리는 수집이 끝난 뒤 한 번만 하는 작업이 아니라, 추적해야 할 데이터의 상태가 만들어질 때마다 수행하는 작업입니다.
이 과정을 ETL(Extract, Transform, Load) 파이프라인으로 구성할 수 있습니다. ETL은 데이터를 가져오고 → 가공하고 → 저장하는 처리 과정입니다. OCR에서는 원본 이미지를 읽고, 필요한 영역을 잘라내거나 크기를 조정한 뒤, 학습용 데이터셋으로 저장하는 예를 들 수 있습니다.
ETL 코드와 설정, 입력·출력 데이터 버전, 실행 이력을 함께 관리해야 어떤 데이터가 어떻게 만들어졌는지 추적하고 다시 생성하는 데 도움이 됩니다.
모델 훈련
문제에 사용할 모델과 입력을 정하고, 준비한 데이터로 모델 내부의 값을 조정합니다. 한 번의 훈련으로 끝내기보다 입력이나 설정을 바꾸며 여러 실험을 비교합니다.
각 훈련 결과에는 어떤 코드와 데이터 버전, 설정을 사용했는지 연결해 기록합니다.
모델 평가와 모델 검증
이 글에서는 두 역할을 구분해 설명합니다. 평가는 모델의 성능을 측정하는 일, 검증은 측정 결과와 운영 조건을 바탕으로 다음 단계에 넘길 수 있는지 판단하는 일입니다. 자료에 따라 용어를 사용하는 범위는 달라질 수 있습니다.
평가에서는 학습에 직접 사용하지 않은 데이터로 성능을 측정합니다. 이미지에서 추출한 ID 번호가 정답과 얼마나 일치하는지 등을 확인합니다.
검증에서는 그 결과가 미리 정한 기준을 충족하는지, 기존 모델보다 나아졌는지, 흐리거나 기울어진 신분증 이미지에서 문제가 생기지 않는지 등을 확인합니다. 필요하면 추론 속도와 서비스 호환성도 함께 검증합니다.
그림의 되돌림 경로는 다음과 같습니다. 전체 과정을 처음부터 반복하는 대신 문제가 확인된 단계에 따라 돌아갈 위치가 달라집니다.
데이터를 수정한 경우에는 새 데이터 버전을 기록한 뒤 다시 훈련합니다. 위 경로는 이 글에서 설명하는 대표적인 반복 경로입니다.
3. 개발·스테이징·프로덕션: 배포까지 전체 흐름 자동화
실험 단계에서 적절한 모델을 찾았다면, 이제 그 모델을 서비스에서 사용할 수 있도록 배포해야 합니다. 데이터를 다시 준비하고 훈련·평가·검증하는 과정도 반복할 수 있어야 하므로, 이후 개발·스테이징·프로덕션 단계에서는 배포까지 포함한 파이프라인 전체를 자동화합니다.
개발 환경에서는 파이프라인을 구현하고 확인합니다. 스테이징에서는 운영과 비슷한 조건에서 배포 전 전체 흐름을 검증하고, 프로덕션에서는 실제 요청을 처리하며 파이프라인과 모델의 상태를 관측합니다.
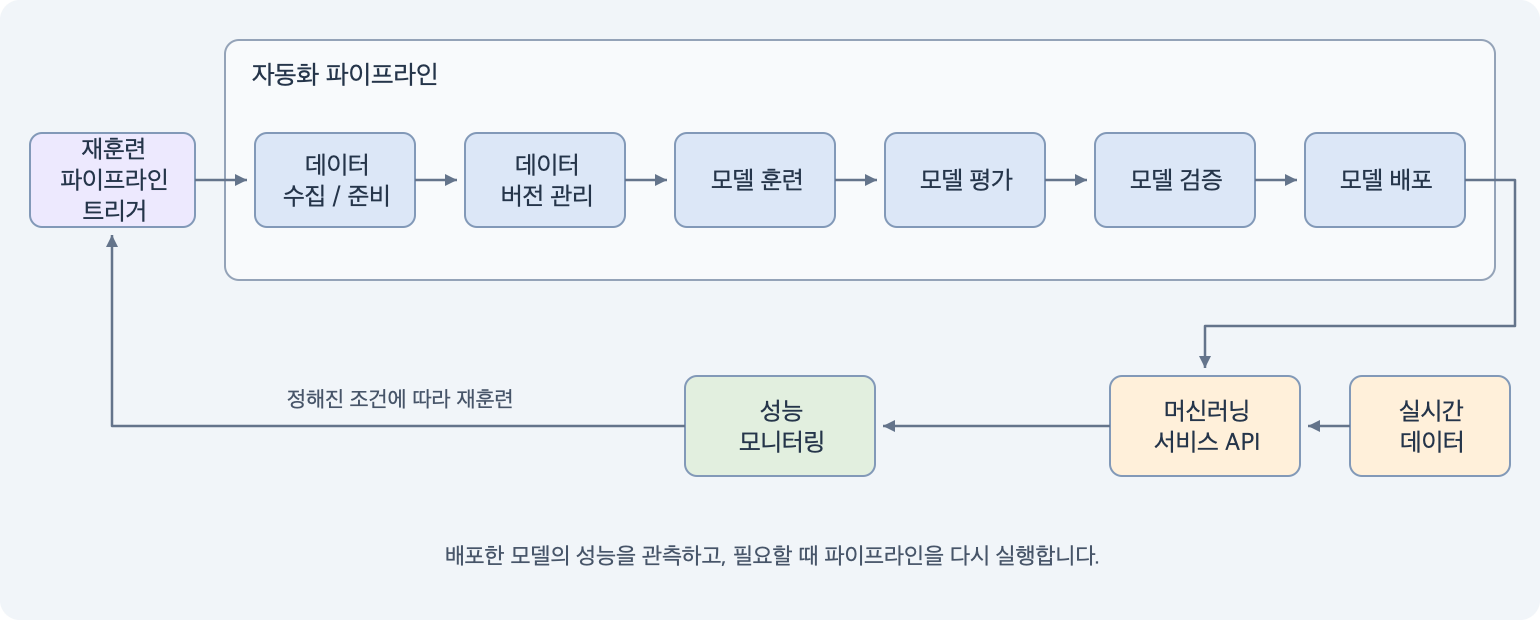
모델 배포: 검증된 모델을 서비스에 연결
실험 단계와 달리 이 단계의 파이프라인에는 모델 배포가 포함됩니다. OCR 프로젝트라면 신분증 이미지를 받아 ID 번호를 반환하는 REST API 형태로 모델을 제공할 수 있습니다.
모델을 배포할 때는 사용할 버전과 실행 환경을 지정하고, 실제 요청을 처리할 수 있는지 확인합니다. 예상 부하에서의 응답 시간과 오류를 확인하는 부하 테스트, 요청 증가에 대응하는 확장, 문제 발생 시 이전 버전으로 돌아가는 롤백도 고려합니다.
환경이 달라도 같은 모델과 입력 처리 코드를 추적할 수 있어야 합니다. 실험에서 사용한 전처리와 운영 코드의 전처리가 다르면, 동일한 모델 파일을 사용해도 결과가 달라질 수 있습니다.
모델 모니터링과 재훈련으로 이어지는 반복
배포 이후에는 요청 수·응답 시간·오류율 같은 운영 지표와 모델 예측 품질을 관측합니다. 서비스가 정상 응답하더라도 ID 번호를 잘못 추출할 수 있으므로, 두 관점은 구분해서 확인해야 합니다.
책에서는 정교한 구성의 경우 성능 지표가 정해진 기준 아래로 떨어지면 트리거가 다시 발동해 전체 과정을 반복한다고 설명합니다. 정해진 일정이나 조건으로 재훈련을 시작하고, 새 모델 역시 평가·검증을 거쳐 배포하는 흐름입니다.
이 과정을 지원하려면 파이프라인 외에도 사용할 모델을 관리하는 레지스트리, 사용자 요청을 받는 모델 API, 운영 결과를 관측하는 모니터링 등의 기능이 필요합니다. 다음 절에서는 이러한 플랫폼 요소를 확장해 설명합니다.
4. 머신러닝 플랫폼
앞에서 살펴본 흐름을 실제로 운영하려면 작업의 실행 순서를 관리하고, 데이터와 모델을 보관하며, 실험을 기록하고 예측 요청을 처리하는 기능이 필요합니다. 이러한 기능을 연결해 제공하는 기반이 머신러닝 플랫폼입니다.
여기서는 파이프라인 내부의 단계를 다시 설명하는 대신, 플랫폼 전체 구성에서 함께 연결되는 파이프라인 오케스트레이션, 피처 스토어, 실험 추적, 모델 레지스트리, 모델 API, 모델 모니터링에 집중합니다. 이 기능은 실험 단계에서도 사용할 수 있으며, 프로덕션에 들어간 뒤에만 생기는 것은 아닙니다.
도구 이름은 역할을 이해하기 위한 대표 오픈소스 예시입니다. 기능이 겹치거나 함께 사용하는 도구도 있으므로, 모두 설치해야 하는 목록으로 볼 필요는 없습니다.
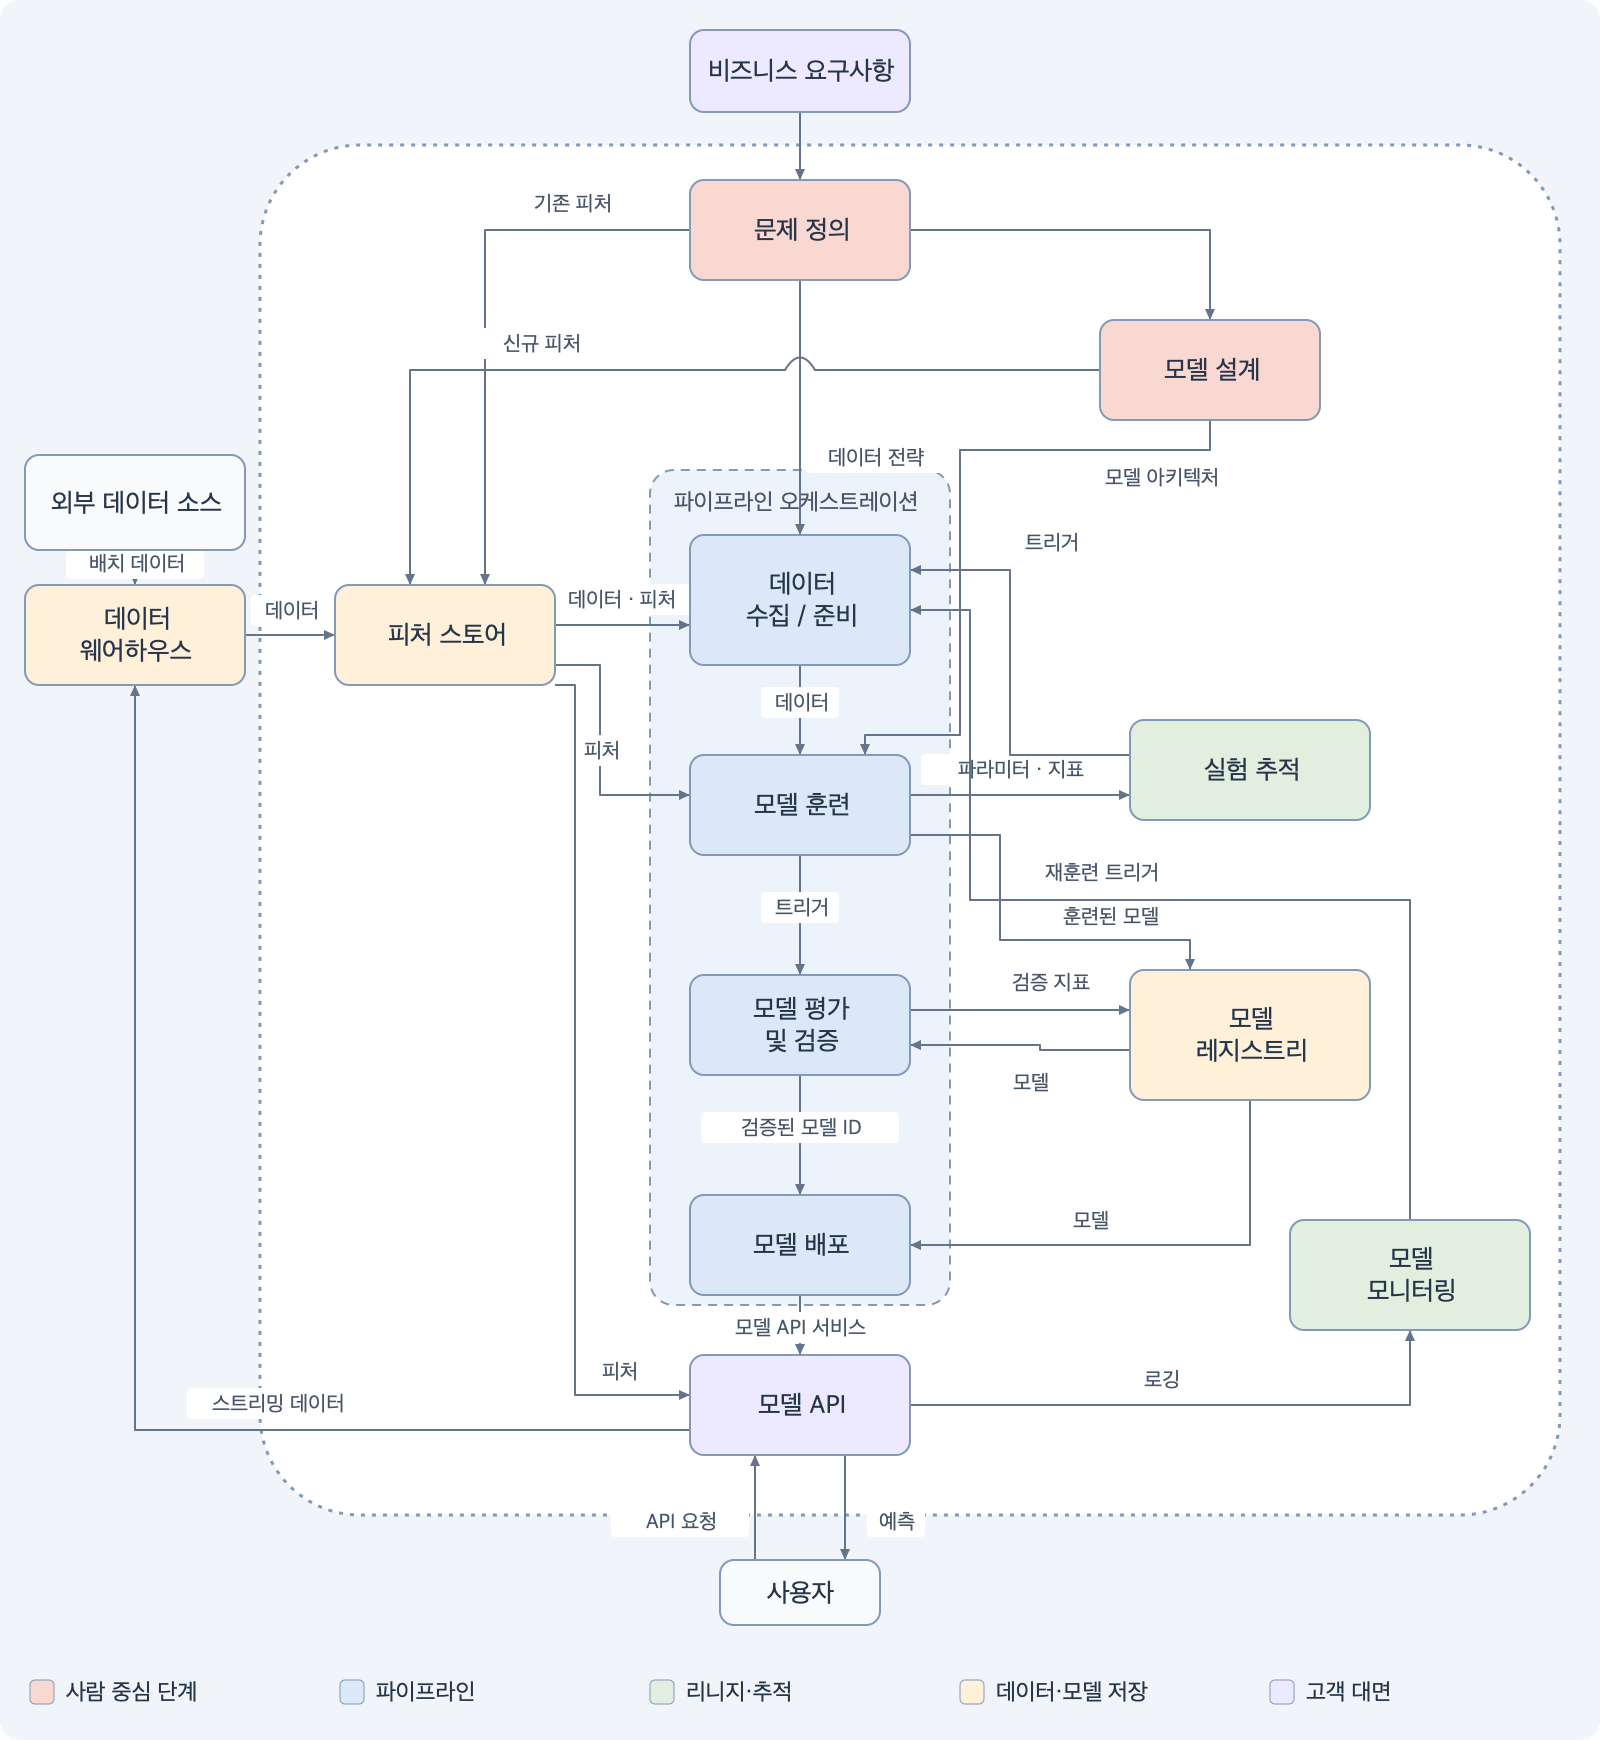
파이프라인 오케스트레이션: 작업의 실행과 연결 관리
실제 머신러닝 프로젝트에서는 훈련 중 데이터를 보완하거나 평가 결과에 따라 모델을 다시 훈련하는 일이 반복됩니다. 각 단계가 복잡하고, 단계 사이에도 루프가 있는 비선형 구조인 경우가 많습니다.
책에서는 이러한 작업을 개별적으로 다루는 대신 모든 단계를 하나의 오케스트레이션 파이프라인으로 통합해 자동화한다고 설명합니다. 복잡한 작업의 실행 순서와 연결 관계를 하나의 흐름으로 관리하기 위한 것입니다.
파이프라인은 여러 작업을 입력과 결과물로 연결한 흐름입니다. 오케스트레이션(Orchestration)은 그 작업들을 순서와 조건에 맞게 실행·관리하는 일입니다. 파이프라인이라고 해서 반드시 작업이 일직선으로만 이어지는 것은 아닙니다. 조건에 따른 분기와 반복 실행도 함께 다룹니다.
예를 들어 데이터 준비의 결과를 훈련에 전달하고, 훈련한 모델을 평가·검증합니다. 결과에 따라 다음 단계로 진행하거나 데이터를 보완하고 재실험합니다. 각 작업을 연결해 두면 실행 상태와 결과를 추적하고 같은 절차를 반복하기 쉬워집니다.
실험 단계에서도 어느 정도 자동화된 파이프라인을 사용할 수 있습니다. 이후 단계에서는 여기에 배포를 연결해 전체 실행 흐름을 자동화합니다. 트리거는 CI나 프로그램 호출에서 발생할 수 있으며, 정해진 작업을 실행하고 평가·검증을 거쳐 모델을 배포합니다.
Kubeflow는 Kubernetes 기반 머신러닝 작업을 지원하는 오픈소스 프로젝트입니다. 그중 Kubeflow Pipelines로 데이터 준비·훈련·평가 작업을 연결하고 실행할 수 있습니다. 모델의 훈련 알고리즘을 대신하는 기능은 아니며, 작성한 작업의 실행 순서와 조건을 관리합니다.
데이터 버전 관리, 실험 추적과 모델 저장소는 파이프라인의 각 작업이 연결해 사용하는 기능입니다. 오케스트레이션은 이러한 기능을 사용하는 작업들의 실행을 조율합니다.
피처 스토어: 훈련과 추론에 필요한 입력 제공
피처(Feature)는 모델이 예측할 때 단서로 사용하는 입력 정보입니다. 예를 들어 모델이 “이 고객이 앞으로 쇼핑몰을 떠날 가능성”을 예측하려면 고객의 행동과 상태를 나타내는 정보가 필요합니다. 아래 표의 각 항목이 모델에 입력하는 피처입니다.
위 값은 설명을 위한 예시입니다. 구매 금액이나 경과 일수처럼 숫자로 표현하는 값은 수치형 피처, 멤버십 등급처럼 종류로 구분하는 값은 범주형 피처입니다. 원본 기록을 계산하거나 집계해 만든 값은 파생·집계 피처라고 합니다. 최근 30일 구매 금액은 수치형이면서 집계해서 만든 피처이기도 합니다.
예를 들어 개별 구매 기록은 원본 데이터이고, 그 기록에서 계산한 “최근 30일 구매 금액 150,000원”은 모델에 넣을 피처입니다. 이 피처들을 입력받은 모델은 고객의 이탈 가능성을 예측합니다. 실제로 이탈했는지를 나타내는 레이블은 피처와 구분하며, 이탈의 기준과 예측할 기간은 프로젝트에서 정해야 합니다.
피처 스토어는 이렇게 준비한 피처를 관리하고, 훈련이나 추론에서 가져다 쓸 수 있게 제공하는 곳입니다. 고객 이탈 예측 모델과 추천 모델이 같은 구매 금액 피처를 사용한다면, 각자 구매 기록 전체를 다시 합산하는 대신 준비된 값을 재사용할 수 있습니다. 반복 실험에서도 같은 피처를 재생성하는 시간과 비용을 줄일 수 있습니다.
또한 “최근 30일 구매 금액”이라는 동일한 정의를 훈련과 서비스에서 함께 사용하도록 관리할 수 있습니다. 새로운 구매가 발생하면 필요한 값을 갱신해야 하므로, 한 번 계산한 값을 계속 고정해 두는 것은 아닙니다.
피처 스토어는 피처를 사용하는 목적에 따라 오프라인 스토어(Offline Store)와 온라인 스토어(Online Store)로 구분할 수 있습니다. 여기서 온라인·오프라인은 인터넷 연결 여부가 아니라, 데이터를 조회하는 용도와 방식의 차이입니다.
오프라인 스토어에서는 “그때 알 수 있었던 정보”로 훈련 데이터를 만듭니다. 예를 들어 9월 1일 시점에서 고객의 이탈 가능성을 예측하는 모델을 훈련한다면, 그 시점까지의 최근 30일 구매 금액을 가져와야 합니다. 9월 1일 이후의 구매 기록까지 포함하면 당시에는 알 수 없었던 미래 정보가 훈련에 섞이기 때문입니다. 이를 피하도록 기준 시점에 맞는 피처를 조회하는 것을 시점 일치 조회(Point-in-time Join)라고 합니다.
온라인 스토어에서는 특정 고객의 피처를 짧은 시간 안에 가져옵니다. 서비스가 고객 A의 이탈 가능성을 예측하려 할 때, 고객 ID로 최근 30일 구매 금액과 멤버십 등급을 조회해 모델에 전달하는 방식입니다. 요청마다 전체 구매 기록을 다시 집계하는 대신 준비된 값을 사용합니다.
두 스토어를 함께 사용한다면, 같은 피처 정의를 바탕으로 과거 이력을 훈련에 사용하고 최신 값을 서비스에 제공합니다. 준비한 피처를 온라인 스토어에 적재·갱신하는 과정은 머터리얼라이제이션(Materialization)이라고 부르기도 합니다. 갱신 주기와 처리 지연에 따라 온라인 스토어의 값도 실제 현재 상태보다 늦을 수 있으므로, 필요한 최신성에 맞춰 갱신해야 합니다. 프로젝트에 따라 오프라인이나 온라인 중 하나만 사용할 수도 있습니다.
Feast는 오프라인·온라인 피처 제공 기능을 구현하는 오픈소스 Feature Store입니다. 오프라인 스토어는 훈련용 과거 피처 조회를, 온라인 스토어는 서비스 추론용 최신 피처의 빠른 조회를 담당합니다. 따라서 `Feast + Offline/Online Store`라고 쓰면 Feast와 별도 제품 두 개를 더하는 것처럼 보일 수 있습니다.
Feast가 두 역할을 연결해 사용할 수 있지만, 피처 값이 실제 저장되는 백엔드는 구성에서 선택해야 합니다. 즉, Feast는 기능을 제공하는 소프트웨어이고 오프라인·온라인 스토어는 그 기능이 다루는 저장·조회 역할입니다. Feast는 원천 데이터를 만드는 전체 수집·처리 파이프라인을 대신하지 않습니다.
피처 스토어가 모든 머신러닝 프로젝트에 항상 필요한 것은 아닙니다.
실험 추적: 어떤 조건에서 어떤 결과가 나왔는지 기록
여러 번 훈련하다 보면 데이터와 설정, 모델이 달라집니다. 실험 추적은 각 실행에 사용한 설정과 성능 지표, 결과물을 연결해 기록합니다.
예를 들어 OCR 모델의 번호 인식 결과가 개선되었다면, 어떤 데이터 버전과 훈련 설정에서 그 결과가 나왔는지 확인할 수 있어야 합니다. 파이프라인의 각 작업이 실행되면서 필요한 기록을 실험 추적 도구에 남깁니다.
MLflow Tracking은 실험의 파라미터·지표·아티팩트를 기록하고 비교하는 기능을 제공합니다. 파이프라인의 실행 순서를 관리하는 오케스트레이션과는 구분되는 역할입니다.
모델 레지스트리: 모델 버전과 사용 대상을 관리
모델 레지스트리(Model Registry)는 훈련한 모델의 버전과 관련 정보를 관리하는 곳입니다. 어떤 실험에서 만들어졌는지, 어떤 모델을 배포에 사용할지 등을 연결해 관리합니다.
실험 추적이 여러 시도의 조건과 결과를 비교하는 데 초점을 둔다면, 모델 레지스트리는 그 결과로 나온 모델을 버전별로 관리하는 데 초점을 둡니다. MLflow는 두 기능을 모두 제공합니다.
모델 파일을 보관하는 저장소와도 다릅니다. 파일 저장소는 실제 파일을 보관하고, 레지스트리는 파일 위치와 버전·실험 이력을 연결합니다. 컨테이너 이미지를 보관하는 이미지 레지스트리와도 구분해야 합니다.
예를 들어 OCR 모델 v2를 배포했는데 문제가 생겼다면, 이전에 사용한 v1을 식별하고 해당 모델로 되돌릴 수 있도록 구성합니다. 레지스트리만 설치한다고 롤백이 자동으로 완성되는 것은 아니며 배포 절차와 연결해야 합니다.
모델 API: 사용자 요청을 예측 기능에 연결
사용자는 보통 모델 파일을 직접 실행하지 않습니다. 애플리케이션이 모델 API에 요청을 보내면, 서비스가 입력을 처리하고 모델을 실행해 결과를 반환합니다.
OCR 프로젝트에서는 신분증 이미지가 요청으로 들어오고, OCR과 번호 추출 과정을 거쳐 ID 번호를 반환하는 형태로 생각할 수 있습니다. 모델을 실행하는 추론 기능과 요청·응답을 처리하는 API를 연결하는 것입니다.
모델 API와 모델 레지스트리는 역할이 다릅니다. 레지스트리는 사용할 모델을 관리하고, API 서비스는 선택한 모델을 불러와 실제 요청을 처리합니다.
BentoML은 모델을 사용하는 API 서비스를 구현하고 패키징하는 오픈소스입니다. 입력 처리와 추론, 결과 반환을 하나의 서비스로 구성할 수 있습니다. 뒤의 오픈소스 아키텍처에서도 BentoML을 모델 API에 연결합니다.
모델 모니터링: 서비스 상태와 예측 품질 관측
모델 API가 정상 응답해도 추출한 ID 번호가 틀릴 수 있습니다. 따라서 서비스가 동작하는지와 모델이 기대한 결과를 내는지를 함께 확인해야 합니다.
번호 추출 정확도를 측정하려면 비교할 정답이 필요합니다. 실제 서비스에서 정답을 곧바로 얻을 수 없다면, 별도로 확인한 표본 등을 이용해 평가하는 체계가 필요합니다.
오픈소스 모니터링 예시로 Prometheus와 Grafana를 함께 사용할 수 있습니다. Prometheus는 서비스나 작업에서 내보내는 요청 수·오류율·응답 시간 등의 시계열 지표를 수집하고 조회합니다. Grafana는 Prometheus의 지표를 대시보드로 보여줍니다.
모델의 예측 품질은 별도로 평가해 지표로 만들어야 합니다. OCR이라면 실제 정답과 모델이 읽은 ID 번호를 비교하는 평가 코드가 필요합니다. Prometheus와 Grafana가 이 정답 비교를 자동으로 수행하지는 않습니다.
책에서는 정교한 구성의 경우 성능 지표가 정해진 기준 아래로 떨어지면 트리거가 다시 발동해 전체 과정을 반복할 수 있다고 설명합니다. 이렇게 모니터링 결과가 파이프라인의 재실행으로 연결됩니다.
저장소와 실행 기반은 여러 요소가 공유
아티팩트(artifact)는 머신러닝 작업에서 만들어지거나 사용하는 파일 형태의 결과물입니다. 예를 들어 훈련된 모델 파일, 준비한 데이터셋, 평가 보고서와 그래프가 아티팩트입니다. 모델 훈련 한 번의 결과로 모델 파일과 평가 보고서가 만들어질 수 있습니다.
아티팩트 저장소는 이런 파일을 보관합니다. 실행에 사용한 설정이나 성능 지표, 파일이 나온 실험과 모델 버전 같은 정보는 메타데이터로 기록해 아티팩트와 연결합니다. 두 정보를 함께 관리하면 어떤 데이터와 설정으로 만든 모델인지 추적하기 쉽습니다.
컨테이너와 Kubernetes는 작업과 서비스를 실행하는 기반으로 사용할 수 있습니다. 아래 그림에서는 저장소를 역할로 표시하고, ML 기능은 Kubeflow·MLflow·Feast·BentoML에 연결합니다.
AWS와 오픈소스로 구성한 머신러닝 플랫폼 비교
앞의 머신러닝 플랫폼 전체 도식을 기준으로, AWS 제품과 책에서 언급한 오픈소스를 각 역할에 매핑했습니다. 두 그림의 블록 위치와 연결선은 같고, 역할 아래에 대응하는 제품 이름을 표시했습니다. 문제 정의와 모델 설계는 사람이 수행하는 단계로 유지합니다.
AWS: Amazon SageMaker AI
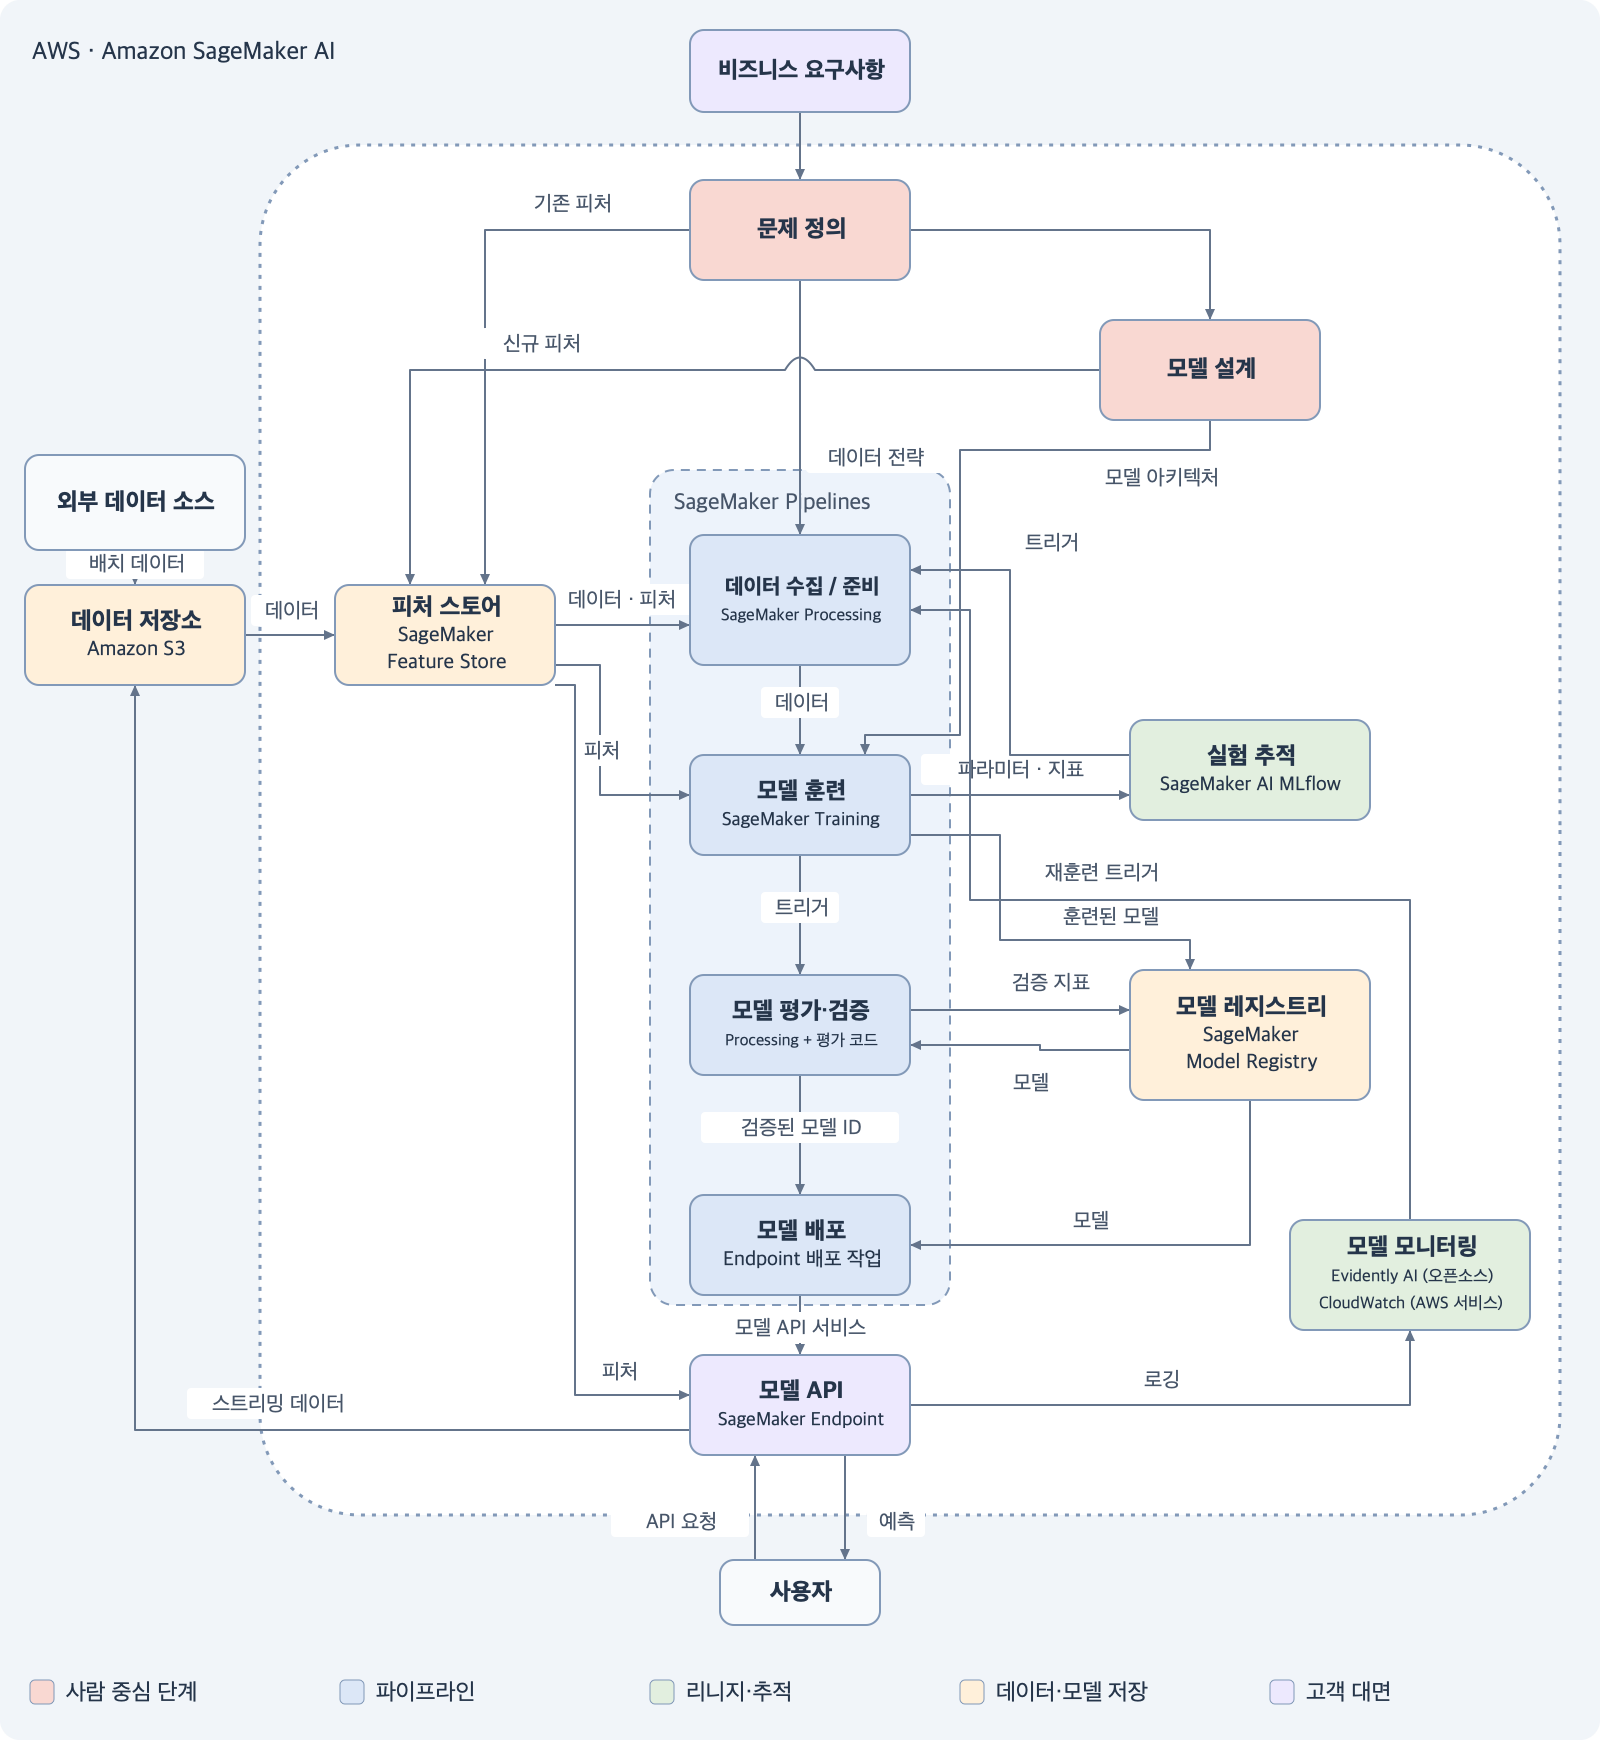
SageMaker Pipelines가 처리·훈련·평가 작업을 연결합니다. 사용할 데이터 버전을 기록하고, 평가 기준을 통과한 모델을 SageMaker Model Registry에 등록한 뒤 실시간 추론 엔드포인트에 배포합니다. 실험의 설정과 지표는 SageMaker AI의 관리형 MLflow에 기록할 수 있습니다.
S3는 데이터·모델 파일을, ECR은 컨테이너 이미지를 보관합니다. 모델 품질은 SageMaker Processing 작업에서 오픈소스 도구인 Evidently AI와 사용자 정의 평가 코드를 실행해 계산합니다. 계산 결과는 AWS 서비스인 CloudWatch에 기록하고, EventBridge 등으로 조건에 따른 재훈련을 연결할 수 있습니다. AWS도 Model Monitor 대체 예시로 AWS 서비스와 Evidently AI를 결합한 구성을 안내합니다.
오픈소스: Kubeflow·MLflow·Feast·BentoML
책에서 언급한 도구를 각 플랫폼 역할에 연결한 구성 예시입니다. Kubeflow는 파이프라인 실행, MLflow는 실험 추적과 모델 등록, Feast는 피처 제공, BentoML은 모델 API를 담당하도록 배치합니다.
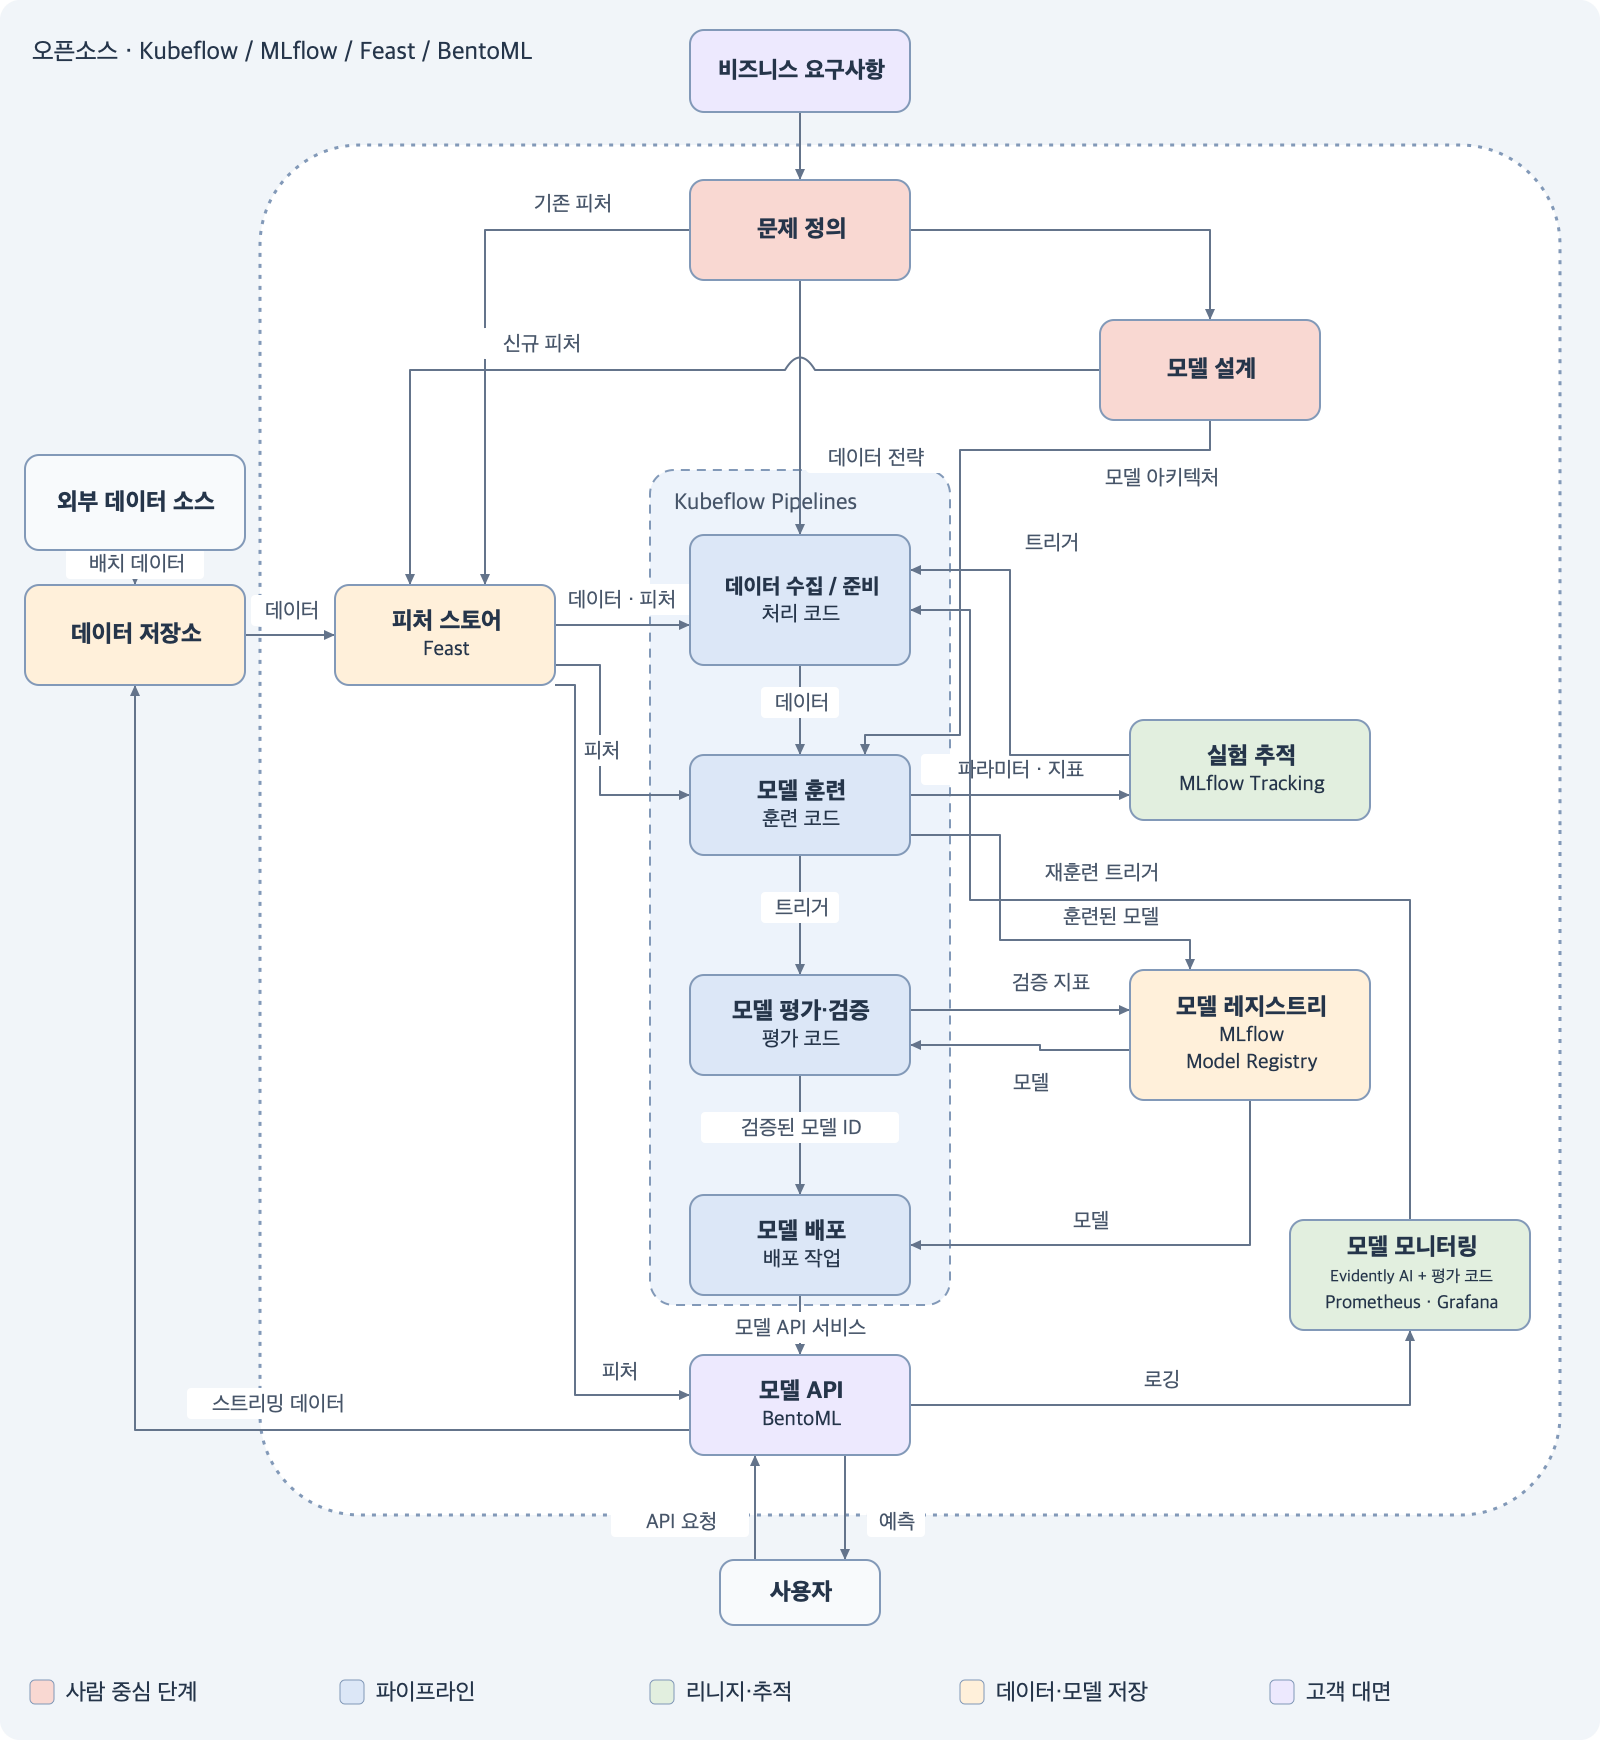
컨테이너 이미지는 Harbor 같은 이미지 레지스트리에 보관할 수 있습니다. 파이프라인의 훈련·평가 작업과 BentoML 서비스가 필요한 이미지를 이곳에서 가져옵니다.
Kubeflow Pipelines가 컨테이너로 작성한 데이터 준비·훈련·평가 작업을 연결합니다. 각 작업은 사용한 코드·데이터 버전과 설정·지표를 MLflow Tracking에 기록하고, 사용할 모델을 MLflow Model Registry에 등록합니다. BentoML로 구성한 API 서비스가 선택한 모델을 사용해 예측 요청을 처리합니다.
Feast는 재사용할 피처가 필요한 경우 훈련과 추론 양쪽에 연결합니다. 데이터·모델 파일과 메타데이터를 보관하는 저장소, 배포 절차와 재훈련 트리거는 각 구성요소에 연결해야 합니다.
모델 품질을 분석하는 Evidently AI도 오픈소스 선택지로 추가할 수 있습니다. 이 도구는 책에서 언급한 내용은 아니며, AWS의 Model Monitor 대체 구성 안내에서 확인한 추가 조사 예시입니다. Prometheus는 시스템·운영 지표를 수집하고 Grafana는 지표를 시각화하므로, 각 도구가 맡는 관측 역할을 구분해 함께 사용할 수 있습니다.
네 도구는 서로를 대체하는 제품이 아니라, 머신러닝 플랫폼의 서로 다른 역할을 맡아 함께 사용하는 구성요소입니다. 각 도구의 설치뿐 아니라 데이터와 결과물 전달, 실행 기록, 모델 배포와 재훈련을 연결하는 작업도 필요합니다.
같은 역할을 나란히 비교
두 구성의 차이는 누가 기반 서비스를 설치·갱신하고 장애에 대응하는가에도 있습니다. AWS에서는 관리형 기능을 연결하고 권한·비용·실행 정책을 구성합니다. 오픈소스 구성에서는 각 도구의 설치·업그레이드·저장소·가용성도 직접 운영해야 합니다. 어느 쪽이든 데이터의 의미, 모델의 통과 기준과 재훈련 조건은 프로젝트에서 정해야 합니다.
5. MLOps는 무엇을 해결하는가
MLOps는 머신러닝의 개발과 운영을 연결하고, 그 과정을 반복 가능하고 신뢰할 수 있게 만드는 실천 방식입니다. 특정 제품이나 Kubernetes 설치 자체를 뜻하지 않습니다.
예를 들어 새 모델의 성능이 좋아졌다면 어떤 데이터, 코드, 설정으로 만들었는지 알아야 합니다. 문제가 발생했을 때는 어떤 모델이 운영 중이었는지 확인하고 이전 모델로 돌아갈 수 있어야 합니다.
이를 위해 코드뿐 아니라 데이터 버전, 학습 설정, 평가 결과, 모델 파일과 배포 이력을 연결해 관리합니다. 여러 사람의 협업과 검증 기준, 책임 분담도 여기에 포함됩니다.
DevOps와 MLOps의 차이
DevOps와 MLOps 모두 자동화와 협업, 검증과 모니터링을 중요하게 다룹니다. MLOps에서는 코드 외에 데이터와 모델의 변화도 운영 결과에 직접 영향을 줍니다.
기존 소프트웨어에서 데이터가 중요하지 않다는 뜻은 아닙니다. 머신러닝에서는 데이터로부터 모델의 동작이 만들어지므로, 데이터와 학습 과정까지 관리 범위가 넓어진다는 점이 핵심입니다.
CI·CD·CT
CI(Continuous Integration)는 변경 사항을 자주 통합하며 자동으로 검증하는 과정입니다. 머신러닝 프로젝트에서도 코드 테스트와 빌드를 실행하고, 필요에 따라 데이터 처리나 모델 관련 검증을 연결할 수 있습니다.
CD는 검증된 변경을 배포 가능한 상태로 유지하는 지속적 전달(Continuous Delivery), 또는 실제 배포까지 자동화하는 지속적 배포(Continuous Deployment)를 가리킵니다. 승인 단계를 둘지는 운영 정책에 따라 다릅니다.
CT(Continuous Training)는 새로운 데이터나 정해진 조건에 따라 모델 학습 과정을 반복할 수 있도록 자동화하는 것입니다. 사용자 요청이 들어올 때마다 학습한다는 뜻은 아닙니다. 새 모델도 평가와 배포 기준을 통과해야 합니다.
6. MLOps 성숙도와 자동화 범위
CI·CD·CT가 각각 어떤 과정을 자동화하는지 살펴봤다면, 이제 이 자동화가 전체 과정에 어느 정도 적용되어 있는지 살펴볼 수 있습니다. 책에서 소개하는 Google의 MLOps 성숙도 구분은 그 범위를 이해하는 기준입니다. 도구를 몇 개 설치했는지로 결정되는 등급은 아닙니다.
Level 0에서도 일부 스크립트나 코드 테스트를 사용할 수 있습니다. Level 1에서는 모델 파일만 넘기는 방식에서 나아가 학습을 반복할 수 있는 흐름을 운영합니다. Level 2는 그 흐름을 구성하는 코드와 컴포넌트의 변경도 지속적으로 검증하고 전달하는 단계입니다.
모든 프로젝트가 처음부터 Level 2를 목표로 할 필요는 없습니다. 먼저 어떤 변경을 재현하기 어렵고 어디서 수작업 오류가 발생하는지 확인한 뒤, 필요한 구간을 자동화하는 것이 현실적입니다.
참고 자료
『머신러닝 플랫폼 엔지니어링』, 1~2장: 머신러닝 수명주기, 플랫폼 구축, MLOps와 DevOps의 비교, MLOps 성숙도. 실험 단계와 개발·스테이징·프로덕션 단계 도식은 각각 그림 1.1과 그림 1.2를, 플랫폼 전체 도식은 그림 1.4를 바탕으로 재구성했습니다.
Google Cloud — MLOps: Continuous delivery and automation pipelines in machine learning: MLOps의 검증·자동화와 성숙도 구분.
JupyterHub, Kubeflow 소개: 개발 환경과 Kubernetes 기반 ML 구성요소.
MLflow Tracking, MLflow Model Registry: 실험 기록과 모델 버전 관리.
Kubeflow Pipelines: ML 워크플로 실행 관리.
Feast 아키텍처: 학습·추론용 피처 제공.
BentoML: 모델 API 구현과 패키징.
Prometheus, Grafana OSS: 지표 수집과 시각화.
Label Studio — OCR 데이터 애노테이션 템플릿: 글자 영역과 정답 텍스트를 표시하는 방법.
Git — What is Git?, OpenLineage, AWS — What is ETL?: 코드 버전 관리, 데이터 리니지와 ETL의 역할 구분.
AWS — SageMaker Pipelines, Model Registry, EventBridge로 파이프라인 실행, Evidently AI 기반 모니터링 대체 구성: AWS 관리형 ML 파이프라인과 모델 관리·관측.
AWS — SageMaker Feature Store: 훈련·추론용 피처 관리.
Feast — Online store, Offline store, 피처 조회 예시, AWS — Feature Store concepts: 과거 피처 조회, 온라인 제공과 피처 적재.
AWS — 관리형 MLflow, MLflow 모델의 SageMaker Model Registry 등록, Kubeflow Pipelines의 MLflow 연동: 두 구성에서 실험 기록과 모델 등록을 연결하는 방법.
Harbor 문서: 컨테이너 이미지 레지스트리의 설치와 사용.
'AI & ML > MLOps Study' 카테고리의 다른 글
| [머신러닝 플랫폼 스터디] 챕터 5 — Kubeflow Pipelines로 배치 추론하기 (0) | 2026.10.31 |
|---|---|
| [머신러닝 플랫폼 스터디] 챕터 4 — MLflow와 Feast로 실험과 피처 관리하기 (0) | 2026.10.31 |
| [머신러닝 플랫폼 스터디] 사전 학습 — 머신러닝과 LLM 이해하기 (0) | 2026.10.23 |